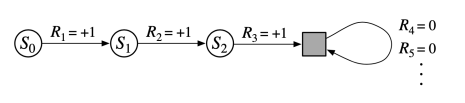Notes

3. Finite Markov Decision Processes

데이터사이언스 대학원 강화학습 수업, Deep RL Bootcamp 를 듣고 정리한 내용입...

데이터사이언스 대학원 강화학습 수업, Deep RL Bootcamp1 를 듣고 정리한 내용입니다.

Markov Decision Processes (MDPs)

Markov decision process (MDP) is a discrete-time stochastic control process. 2

마르코프 결정 프로세스에서 행동(Actions)은 현재의 보상(Rewards)에 영향을 줄 뿐만 아니라 다음 상태(States)에도 영향을 준다.

Agent–Environment Interface

HeadImg

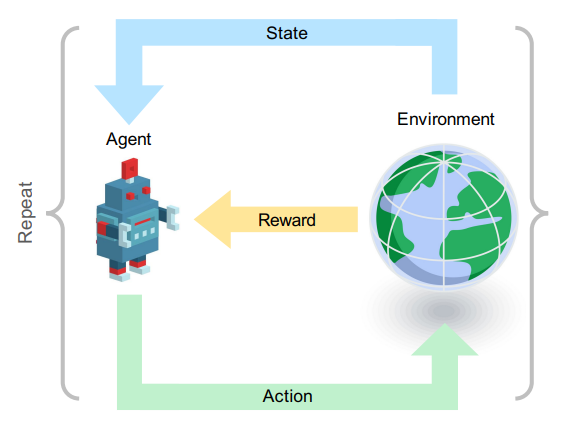
Agent-Environment Interface Agent-Environment Interface에서는 다음과 같은 상황을 서술한다. 매 time stamp t=0,1,2,⋯t=0, 1, 2, \cdots 마다

  1. Agent는 상태(State) 정보 St∈SS_t \in \mathcal{S}를 받는다.
  2. Agent는 행동(Action) At∈A(st)A_t \in \mathcal{A(s_t)}을 취한다.
  3. 한 스텝 이후(t+1t+1), Agent는 보상 Rt+1R_{t+1}을 받고 다음 상태 St+1S_{t+1}가 결정된다.

따라서 이러한 상호작용은 일련의 시퀀스(혹은 trajectory) S0,A0,R1,S1,A1,R2,A2,R3,⋯S_0, A_0, R_1, S_1, A_1, R_2, A_2, R_3, \cdots 를 생성한다.

Dynamics of MDP

Dynamics function은 두 개의 현재와 다음 상태(StS_t, St+1S_{t+1}), 보상(RtR_t), 그리고 행동(AtA_t)를 받아서 00과 11로 사이의 확률로 매핑해주는 함수다.

p:S×R×S×A→[0,1]p: \mathcal{S} \times \mathcal{R} \times \mathcal{S} \times \mathcal{A} \rightarrow \lbrack 0, 1 \rbrack

이 함수는 현재 상태, 행동이 주어졌을 때 다음 상태와 보상을 기술한다. s′,s∈S,r∈R,a∈A(s)s', s \in \mathcal{S}, r \in \mathcal{R}, a \in \mathcal{A(s)} 일때 확률은 다음과 같다.

p(s′,r∣s,a):=P{St=s′,Rt=r∣St−1=s,At−1=a}p(s', r \vert s, a) := \Bbb{P} \lbrace S_t = s', R_t = r \vert S_{t-1}=s, A_{t-1}=a \rbrace

Markov Property

“The future is independent of the past given the present.”

Markov의 중요한 특성은 현 시점에서 모든 과거는 미래와 독립적인 관계라는 것이다. 상태 ss가 Markov 특성을 지녔다라는 것은 다음과 같다. 모든 과거 정보 {S0,A0,⋯ ,St−1,At−1}\lbrace S_0, A_0, \cdots, S_{t-1}, A_{t-1} \rbrace는 이미 상태에서 내포되어 있기 때문이라는 가정이 숨겨져 있다.

P{St=s′,Rt=r∣St−1=s,At−1=a}=P{St=s′,Rt=r∣S0,A0,⋯ ,St−1=s,At−1=a}\Bbb{P}\lbrace S_t = s', R_t = r \vert S_{t-1}=s, A_{t-1}=a \rbrace = \Bbb{P} \lbrace S_t = s', R_t = r \vert S_0, A_0, \cdots, S_{t-1}=s, A_{t-1}=a \rbrace

MDP dynamics p(s′,r∣s,a)p(s', r \vert s, a)를 사용하여 다른 항들을 계산 할 수 있다.

“MDP calculation from dynamics”
State-trainsition
p(s′∣s,a):=P{St=s′,∣St−1=s,At−1=a}=∑r∈Rp(s′,r∣s,a) p(s' \vert s, a) := \Bbb{P}\lbrace S_t = s', \vert S_{t-1}=s, A_{t-1}=a \rbrace = \sum_{r \in \mathcal{R}} p(s', r \vert s, a)
Expected rewards for state–action pair
r(s,a):=E[Rt∣St−1=s,At−1=a]=∑r∈Rr∑s′∈Sp(s′,r∣s,a) r(s, a) := \Bbb{E} \lbrack R_t \vert S_{t-1}=s, A_{t-1}=a \rbrack = \sum_{r \in \mathcal{R}} r \sum_{s' \in \mathcal{S}} p(s', r \vert s, a)
Expected rewards for state–action-next-state triple
r(s,a,s′):=E[Rt∣St−1=s,At−1=a,St=s′]=∑r∈Rrp(s′,r∣s,a)p(s′∣s,a) r(s, a, s') := \Bbb{E} \lbrack R_t \vert S_{t-1}=s, A_{t-1}=a, S_t = s' \rbrack = \sum_{r \in \mathcal{R}} r \dfrac{p(s', r \vert s, a)}{p(s' \vert s, a)}

HeadImg

이 그림은 세 개의 State S={s0,s1,s3}\mathcal{S} = \lbrace s_0, s_1, s_3 \rbrace, 두 개의 행동 A={a0,a1}\mathcal{A} = \lbrace a_0, a_1 \rbrace 이 존재한다. 또한, +5+5와 −1-1을 제외하고 나머지는 모두 00의 보상을 가진다. 몇 가지 예제로 MDP를 이해해보자.

  1. s1s_1 상태에서 시작하여 a0a_0의 행동을 취한 경우, s0s_0 와 보상 r=5r=5를 얻을 확률은 p(s0,5∣s1,a0)=0.7p(s_0, 5 \vert s_1, a_0) = 0.7.
  2. s1s_1 상태에서 행동 a0a_0을 취했을 때, s2s_2로 전환될 확률은 p(s2∣s1,a0)=0.2p(s_2 \vert s_1, a_0) = 0.2.
  3. s1s_1 상태에서 행동 a0a_0의 기댓값:
r(s1,a0)=5⋅p(s0,5∣s1,a0)+0⋅p(s1,0∣s1,a0)+0⋅p(s2,0∣s1,a0)=5⋅0.7+0⋅0.1+0⋅0.2=3.5 \begin{aligned} r(s_1, a_0) &= 5 \cdot p(s_0, 5 \vert s_1, a_0) + 0 \cdot p(s_1, 0 \vert s_1, a_0) + 0 \cdot p(s_2, 0 \vert s_1, a_0) \\ &= 5 \cdot 0.7 + 0 \cdot 0.1 + 0 \cdot 0.2 = 3.5 \end{aligned}
MDP 프레임워크에서 경계값은 꼭 Agent의 물리적 경계값 일 필요는 없다. 또한, MDP 프레임워크에서 Agent는 환경(Environment)을 임의대로 변경 할 수 없다.

Reward Hypothesis

The goal of the agent is the maximization of the expected value of the cumulative sum of a received scalar (reward) signal.

Agent의 최종 목적은 보상 합의 기댓값을 최대화 하는 것이다. 목적을 달성하기 위해서 sub-goal를 추가하는 것이 도움이 될까? 도움이 될 수도 있고 안될 수 도 있다. 예를 들어, 체스게임에서 퀸을 잡는 것이 중요하다는 것을 sub-goal로 두어서 왕을 제외한 다른 모든 말들을 희생시켰다면, 이는 최종 목표인 게임 승리에 도움이 안된다(물론 적은 말들로 달성 했을 수도 있지만…).

Agent 목표 장기적인 보상 합의 최대화를 달성하기 위해서 **기대 수익(expected return)**을 GtG_t 라고 하면 두 가지 시나리오에서 수식으로 다음과 같이 정의 할 수 있다.

“Expected Reward from difference scenario”
Episodic
Gt:=Rt+1+Rt+1+⋯+RT G_t := R_{t+1} + R_{t+1} + \cdots + R_T
Continuing
Gt:=Rt+1+γRt+1+⋯+=∑k=1∞γkRt+k+1 G_t := R_{t+1} + \gamma R_{t+1} + \cdots + = \sum_{k=1}^{\infty} \gamma^k R_{t+k+1}
여기서 $\gamma \in \lbrack 0, 1 \rbrack$는 할인율(discount rate)이라고 한다. 
Episodic + Continuning

HeadImg

이러한 모형을 absorbing state라고 한다. $T = \infty$ 혹은 $\gamma = 1$
Gt:=∑k=t+1Tγk−t−1Rk G_t := \sum_{k=t+1}^{T} \gamma^{k-t-1} R_k

Policies and Value Functions

Policy는 주어진 상태 St=sS_t = s 에서 가능한 행동 At=aA_t = a으로 매핑하는 함수 πt(a∣s)\pi_t(a \vert s)다. Policy 함수는 항상 확률 함수일 필요는 없다. 예를 들어 다음과 같은 deterministic policy 도 존재한다.

πt(a∣s)={1where a=a′0where a≠a′\pi_t(a \vert s) = \begin{cases} 1 & \text{where } a=a' \\ 0 & \text{where } a\neq a' \end{cases}

Policy가 확률 함수의 경우 선택된 행동의 실패 확률을 보통 noise라고 한다. 예를 들어, 특정 상태 ss에서 a,a′a, a' 두 개의 행동을 선택할 수 있는 경우, πt(a∣s)=0.9\pi_t(a \vert s) = 0.9 이면 aa를 선택할 확률이 90%이고, a′a'를 선택할 확률은 10%이다(noise).

γ\gamma는 할인율으로써 0≤γ≤10 \leq \gamma \leq 1의 값을 가지며, 돈의 미래가치를 생각하면 이해가 된다. 현재 1만원을 가지고 있으면 지금은 1만원의 가치가 있지만, 내년에는 할인율에 따라 1만원 보다 적은 가치를 가지게 된다(10000×gamma)(10000 \times gamma).

Value Function은 {==Policy가 주어졌을 때==}, 상태(혹은 상태-행동 쌍)가 얼마나 좋은 지를 평가하는 함수다. 왜 좋은지를 평가해야하고 좋은 평가는 무엇인지는 앞으로 차차 알아가 본다.

  • policy π\pi하에 State-value function:
vπ(s):=Eπ[Gt∣St=s]=Eπ[∑k=0∞γkRt+k+1∣St=s] v_{\pi}(s) := \Bbb{E}_{\pi} \lbrack G_t \vert S_t = s\rbrack = \Bbb{E}_{\pi} \Bigg\lbrack \sum_{k=0}^{\infty} \gamma^k R_{t+k+1} \vert S_t = s \Bigg\rbrack
  • policy π\pi하에 Action-value function:
qπ(s,a):=Eπ[Gt∣St=s,At=a]=Eπ[∑k=0∞γkRt+k+1∣St=s,At=a] q_{\pi}(s, a) := \Bbb{E}_{\pi} \lbrack G_t \vert S_t = s, A_t = a\rbrack = \Bbb{E}_{\pi} \Bigg\lbrack \sum_{k=0}^{\infty} \gamma^k R_{t+k+1} \vert S_t = s, A_t = a \Bigg\rbrack

Bellman Equation

**벨만 방정식(Bellman Equation)**은 현재 상태(ss)의 value와 다음 상태(s′s')의 value 관계를 보여주는 식이다.

vπ(s):=Eπ[Gt∣St=s]=Eπ[Rt+1+γGt+1∣St=s]=∑aπ(a∣s)∑s′∑rp(s′,r∣s,a)[r+γEπ[Gt+1∣St+1=s′]]=∑aπ(a∣s)∑s′∑rp(s′,r∣s,a)[r+γvπ(s′)]\begin{aligned} v_{\pi}(s) & := \Bbb{E}_{\pi} \lbrack G_t \vert S_t = s\rbrack \\ &= \Bbb{E}_{\pi} \lbrack R_{t+1} + \gamma G_{t+1} \vert S_t = s\rbrack \\ &= \sum_a \pi(a \vert s) \sum_{s'} \sum_{r} p(s', r \vert s, a) \big\lbrack r + \gamma \Bbb{E}_{\pi} \lbrack G_{t+1} \vert S_{t+1} = s' \rbrack \big\rbrack \\ &= \sum_a \pi(a \vert s) \sum_{s'} \sum_{r} p(s', r \vert s, a) \lbrack r + \gamma v_{\pi}(s') \rbrack \end{aligned}

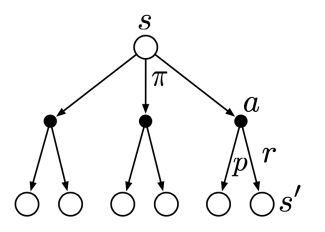
아래 그림은 bellman-backup diagram 이라는 그림인데, Bellman Equation을 잘 설명하고 있다. 즉, policy π\pi 하에 현재 상태-가치(state-value) vπ(s)v_{\pi}(s) 는 모든 기대 수익을 각각의 행동에 따른 가중 평균을 구하는 것이며, 각 기대 수익은 할인된 다음 상태-가치 γvπ(s′)\gamma v_{\pi}(s') 와 다음 보상 rr의 합을 가중 평균함으로써 구할 수 있다. HeadImg

“Example: Grid-World”

아래의 좌측 그림 처럼 지도가 있는데, 네 개의 행동 A={N,S,E,W}\mathcal{A} = \lbrace N, S, E, W \rbrace을 취할 수 있다. 그리고 웜홀이 있어서 AA 에서 A′A'로 전송하는 웜홀을 타면 +10+10, BB 에서 B′B'로가는 웜홀을 타면 +5+5, 그리고 지도 밖을 벗어나면 −1-1를 받는 보상 상황이 주어졌다. 여기서 각각의 grid(네모칸)은 state라고 할 수 있다. 따라서, state transition은 결정적이다. 우측 그림은 state value를 구한 것이다. 우측 그림에서 볼 수 있듯이 A와 B grid(state)에서 높은 value를 갖는다.

HeadImg

Optimal Policies and Optimal Value Functions

Policy의 비교는 주어진 policy π\pi하에서 state-value vπ(s)v_{\pi}(s) 가 높으면 좋은 것이다 (주의: state-value function이 항상 monotic한 것은 아니다). 따라서 최적의 policy π∗\pi_{*}는 주어진 상태 ss에서 다른 {++모든 policy++} 보다 좋은 state-value를 가지면 된다. 이 최적의 state-value를 optimal state-value function 이라고 하며 다음과 같이 정의 된다.

v∗(s):=maxπ vπ(s)∀s∈sv_{*}(s) := \underset{\pi}{max} \ v_{\pi}(s) \quad \forall s \in \mathcal{s}

또한, 최적의 action-value function도 같이 정의할 수 있다.

q∗(s,a):=maxπ qπ(s,a)∀s∈s,a∈A=E[Rt+1+γv∗(St+1)∣St=s,At=a]\begin{aligned} q_{*}(s, a) & := \underset{\pi}{max} \ q_{\pi}(s, a) \quad \forall s \in \mathcal{s}, a \in \mathcal{A} \\ &= \Bbb{E} \lbrack R_{t+1} + \gamma v_{*}(S_{t+1}) \vert S_t = s, A_t = a \rbrack \end{aligned}

Bellman Optimality

“The value of a state under an optimal policy must equal the expected return for the best action from that state.”

v∗v_{*}를 구하기 위한 Bellman Optimality Equation은 다음 수식과 같이 정의된다. 이 수식의 뜻은 최적의 policy π∗\pi_{*} 하에 상태의 가치 v∗v_{*}는 해당 상태에서 나오는 최적 행동의 기대 수익이다.

v∗(s):=max⁡a∈A(s)qπ∗(s,a)=max⁡aEπ∗[Gt∣St=s]=max⁡aEπ[Rt+1+γv∗(St+1)∣St=s,At=a]=max⁡a∑s′,rp(s′,r∣s,a)[r+γvπ∗(s′)]\begin{aligned} v_{*}(s) & := \underset{a \in \mathcal{A(s)}}{\max} q_{\pi_{*}}(s, a) \\ &= \underset{a}{\max} \Bbb{E}_{\pi_{*}} \lbrack G_t \vert S_t = s\rbrack \\ &= \underset{a}{\max} \Bbb{E}_{\pi} \lbrack R_{t+1} + \gamma v_{*}(S_{t+1}) \vert S_t = s, A_t = a \rbrack \\ &= \underset{a}{\max} \sum_{s', r} p(s', r \vert s, a) \lbrack r + \gamma v_{\pi_{*}}(s') \rbrack \end{aligned}

이전의 Bellman backup diagram과 다르게 최적 상태-가치(optimal state-value)를 구하기 위해서 v∗v_{*} 이제는 기대 수익을 모든 행동에 대한 가중 평균 합이 아니라 최적 행동에 해당하는 기대 수익만 선택하면 되는 것이다. 그리고 최적 행동 가치(optimal action-value)는 선택된 최적 상태-가치를 보상에 대한 가중 평균 하면 되는 것이다. HeadImg

또한 Bellman optimality equation은 v∗v_*에 대해 단 하나의 유일한 솔루션을 가진다.

“Example: Grid-World 에서의 optimal value function과 policy”

중간의 그림이 optimal state-value 이고 우측은 optimal policy다. 각 state에서 여러 optimal policy를 가질 수 있지만, optimal state-value는 단 하나다. 예를 들어, 좌표 (4, 0)에서는 N으로 이동하던 E로 이동하던 모두 최적의 v∗v_{*}를 얻을 수 있다.

HeadImg

ETC

두 개의 policy πA\pi_A, πB\pi_B가 있는데, 어떤 state에서 optimal state-value가 πA\pi_A가 더 큰 경우가 있고, 어떤 state에서는 πB\pi_B가 더 크다. 그렇다면 optimal policy는 없는 것일까? 아니다. 각 state에서 state-value가 큰 policy를 선택해서 새로운 policy πC\pi_C를 만들면 된다. 따라서, 항상 vπ(s)≥vπ′(s)v_{\pi}(s) \geq v_{\pi^{'}}(s)를 만족하는 π\pi를 찾을 수 있다.

Footnotes

  1. Deep RL Bootcamp ↩

  2. Wikipedia - Markove Decision Processes ↩